理解模型、输入与验证的关系,不让技术名词变成预测承诺。 本文将相关概念拆成可以逐步检查的说明,并附上具体例子与独立练习。阅读时请同时保留示例前提,不将固定图形的结论直接扩展到未说明的外部情形。
AI 可以帮助整理与解释
在资料充分时,模型能辅助归类记录、生成图表说明、检查字段异常或归纳常见问题。这些工作有助于提高整理效率,但仍需要核对原始材料。模型生成一段流畅解释,不代表其中每个数字和因果判断都已经得到验证,尤其不能自动补全缺失记录。
输入质量决定分析基础
标签错位、重复样本和选择性截图都会影响模型结果。即使算法复杂,也无法从错误输入中保证得到正确结论。分析前应先定义样本单位、核对来源、处理缺失,并保留可追溯编号。没有这一层基础,换一个更大的模型常常只是更快地产生不可靠输出。
模型可能记住历史噪声
当特征很多而样本很少时,模型可能把偶然波动当成规律,在已有数据上表现很好,在新数据上失效。需要使用未参与训练的数据检验,并与简单基线比较。训练表现、验证表现与真实使用表现应分别报告,不能只展示最好看的一个数字。
未知随机机制不能靠名称穿透
若事件在相应条件下独立且没有可观察的有效信号,给模型加上 AI 标签不会自动创造预测信息。任何声称稳定优势的系统都应说明信息来源、测试方法与限制。本站分析内容用于理解方法,不提供实时预测、保证命中率或收益承诺。
把知识放回一个具体例子
教学示例
模型可以把一张人工整理表中重复的编号标出来,再由读者核对原图;它不能仅凭十张精选结果截图确认真实生成机制。前者是可复查的数据辅助,后者则需要截图之外的机制资料和完整验证。
独立练习:检验你是否真正理解
给 AI 一份故意含重复编号和缺失值的小表,要求它只指出异常,不补造未知结果。随后逐项人工核对,记录发现与漏检。再把一个看似很高的训练成绩交给它解释,检查是否同时提及验证样本与基线。这个练习把 AI 放在可复查的辅助位置。评价工具时,应看它解决的具体任务及错误类型,而不是只看输出是否流畅,或模型名称是否听起来足够先进。
演示数据与分析边界
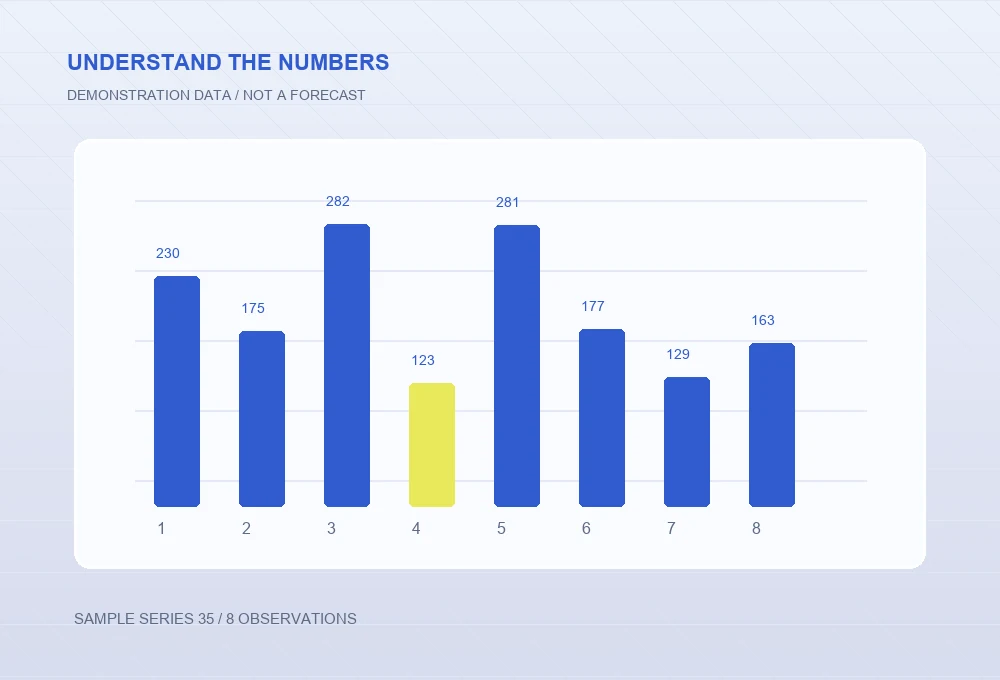
本栏目中的数字、序列和图表用于解释统计概念,均为教学演示,并非实时游戏结果或业务监测。分析前应明确样本单位、记录方式与机制假设,分析后保留局限与不确定性。历史表现只能描述给定资料,不能自动证明未来具有相同结果,更不构成命中率或收益保证。涉及独立性、均匀分布等性质时,必须同时保留其成立条件,不能从几张截图直接推断。
阅读检查清单
- 先查原始资料。
- 防止模型补造数据。
- 训练验证分开。
- 与基线比较。
- 保留人工复核。
- 不接受 AI 即有效的推断。